

Benutzerdefinierte Segmentierung
Jedes Mal, wenn du XML-, HTML-, MD- oder andere Quelldateien ohne Key-Value-Struktur hochlädst, werden die vordefinierten Segmentierungsregeln (SRX 2.0) zur automatischen Inhaltssegmentierung verwendet. Es kann jedoch Situationen geben, in denen die Standard-Segmentierungsregeln Quelldateien entgegen den gewünschten Erwartungen segmentieren.
In diesem Fall kannst du mithilfe des SRX-2.0-Standards eigene Segmentierungsregeln für jede Quelldatei definieren.
Du kannst die Segmentierung unter Quellen > Dateien ändern.
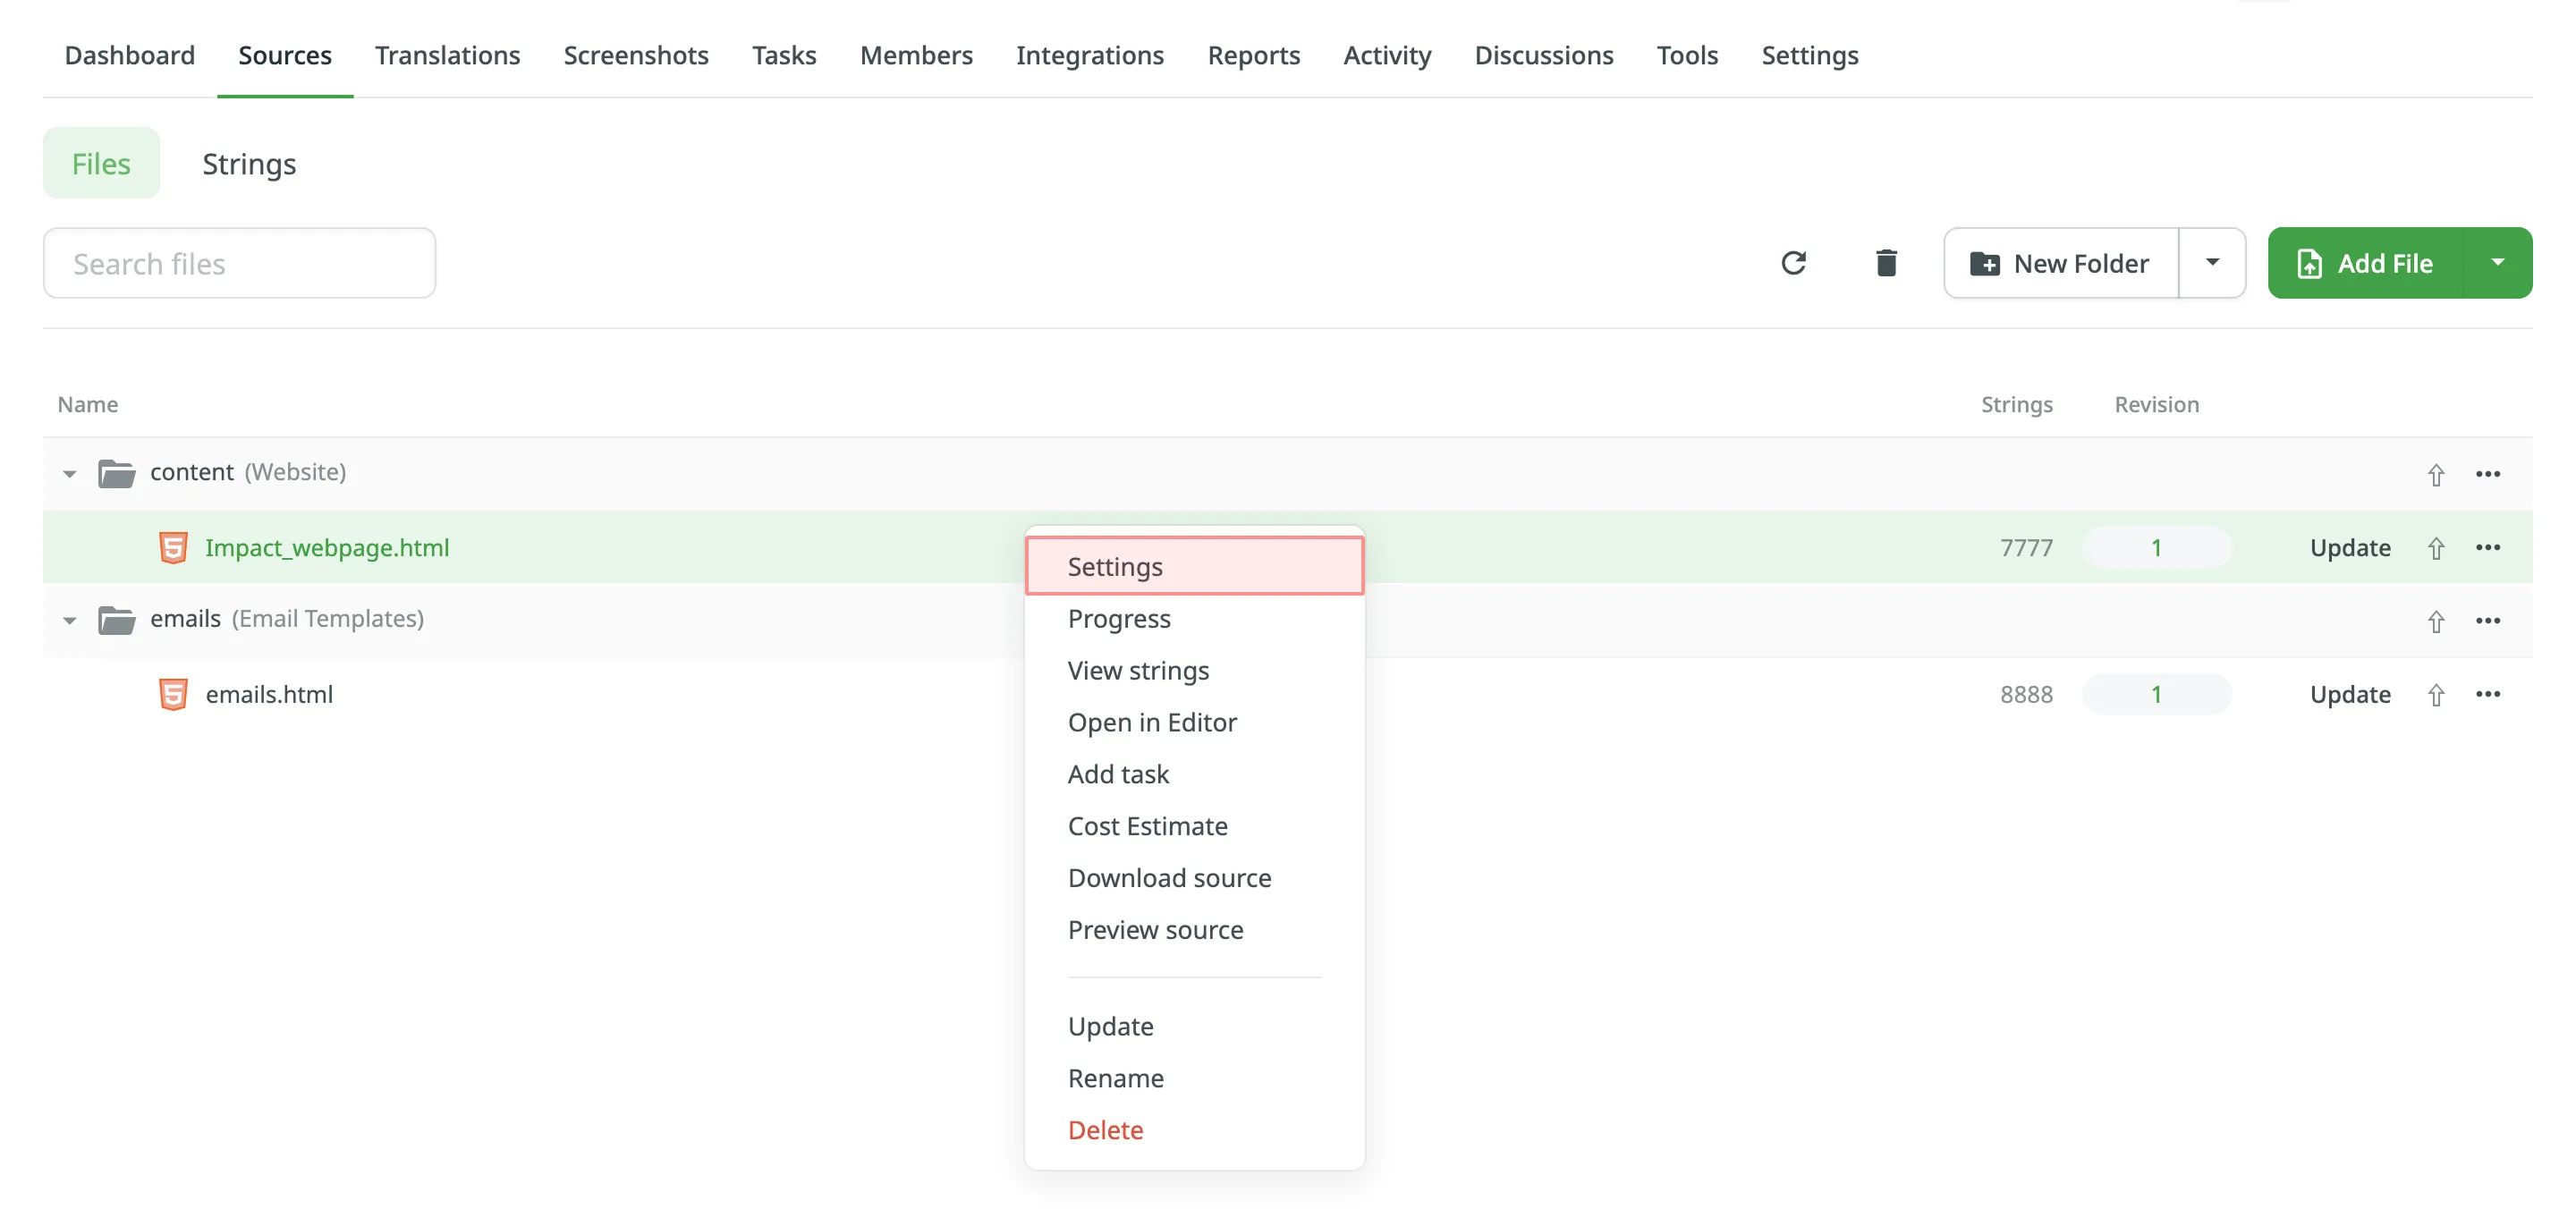
- Öffne das Projekt, in dem du die Segmentierungsregeln anpassen möchtest, und gehe zu Quellen > Dateien.
- Klicke auf (oder mit der rechten Maustaste) auf die gewünschte Datei und wähle Einstellungen.
- Wechsle im geöffneten Dialog zum Tab Parser-Konfiguration.
- Wähle Inhaltssegmentierung aktivieren und Benutzerdefinierte Segmentierungsregeln verwenden.
- Füge deine SRX-Segmentierungsregeln ein und klicke auf Speichern.
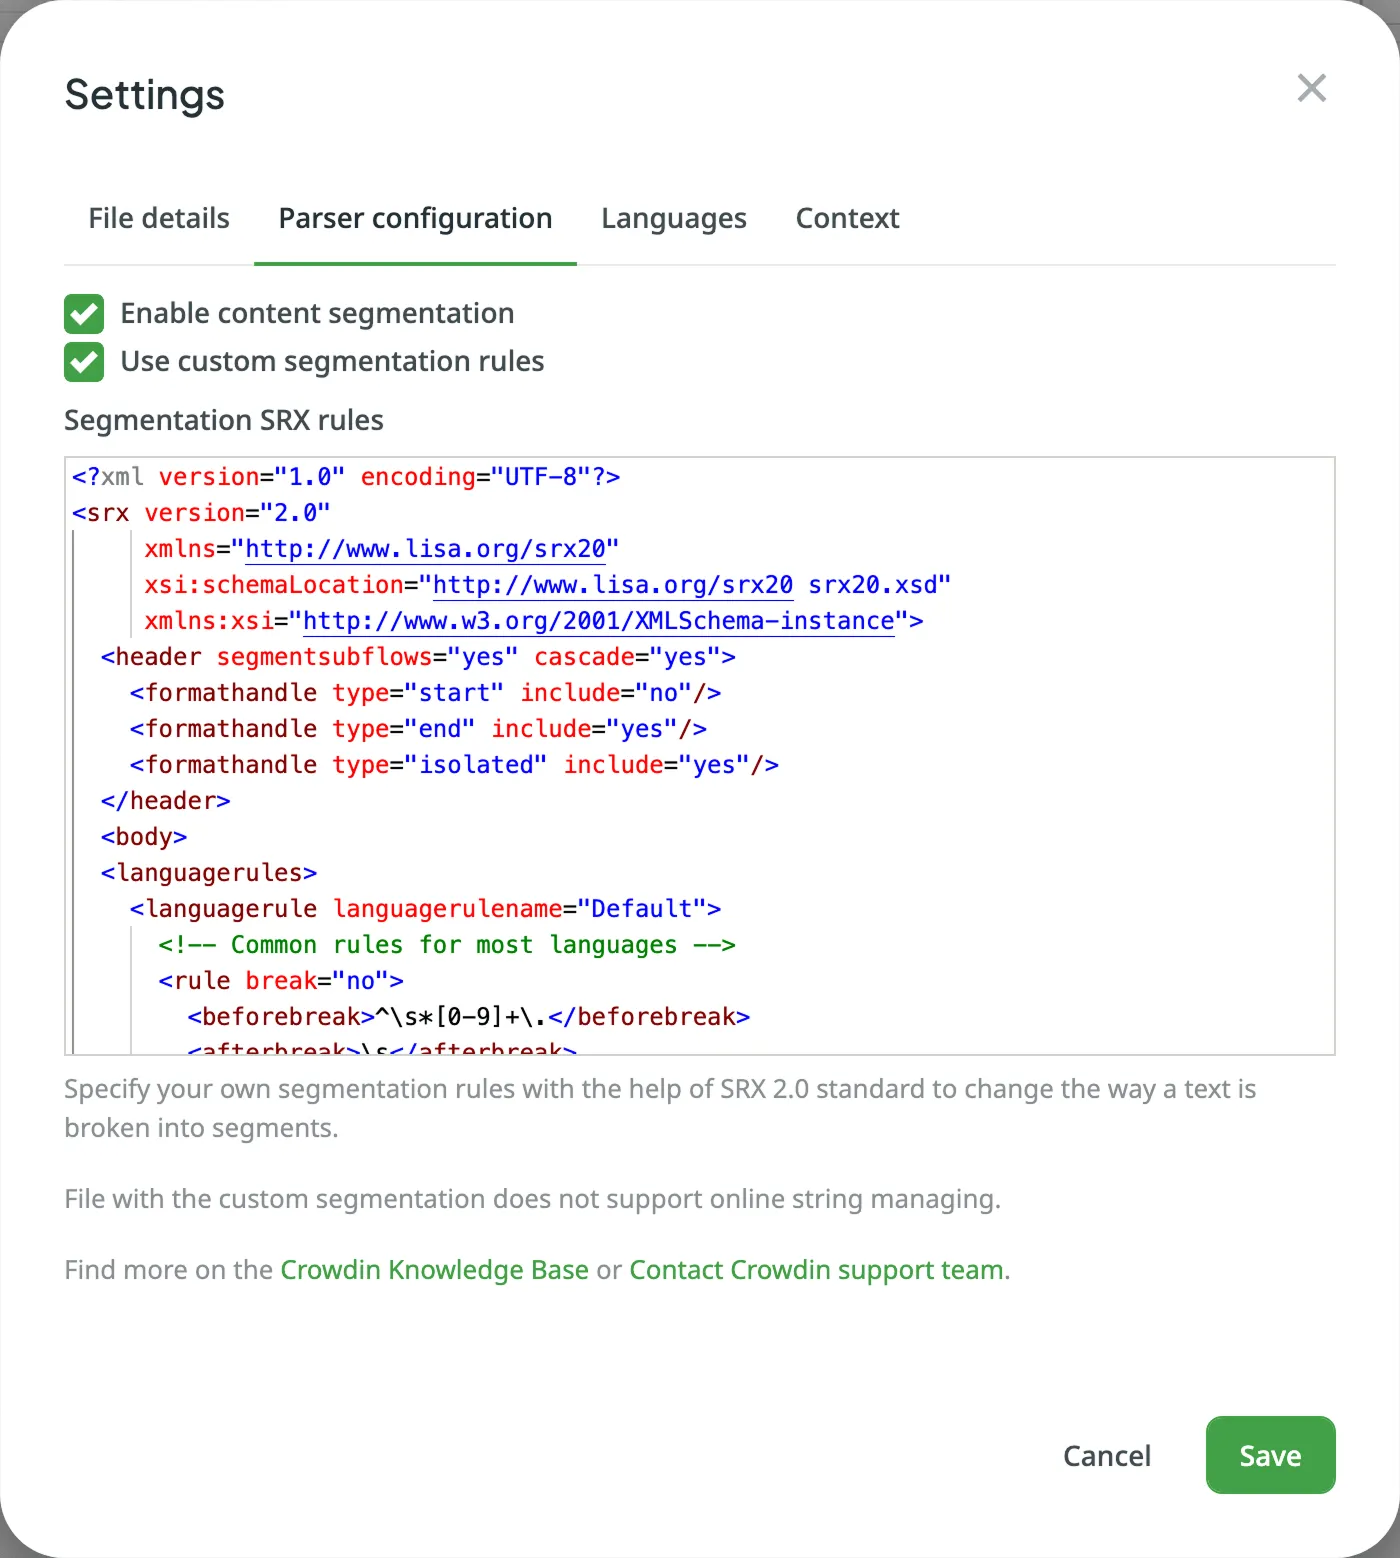
Nachdem du deine neuen Segmentierungsregeln gespeichert hast, wird deine Quelldatei automatisch erneut importiert und gemäß diesen neuen Regeln segmentiert.
Eine typische SRX-Datei sieht etwa so aus:
<?xml version="1.0" encoding="UTF-8"?><srx version="2.0" xmlns="http://www.lisa.org/srx20" xsi:schemaLocation="http://www.lisa.org/srx20 srx20.xsd" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"> <header segmentsubflows="yes" cascade="yes"> <formathandle type="start" include="no"/> <formathandle type="end" include="yes"/> <formathandle type="isolated" include="yes"/> </header> <body> <languagerules> <languagerule languagerulename="Default"> <!-- Allgemeine Regeln für die meisten Sprachen --> <rule break="no"> <beforebreak>^\s*[0-9]+\.</beforebreak> <afterbreak>\s</afterbreak> </rule> <rule break="yes"> <afterbreak>\n</afterbreak> </rule> <rule break="yes"> <beforebreak>[\.\?!]+</beforebreak> <afterbreak>\s</afterbreak> </rule> </languagerule> </languagerules> <maprules> <!-- Ausnahmen zuerst auflisten --> <languagemap languagepattern="[Ee][Nn].*" languagerulename="English"/> <languagemap languagepattern="[Ff][Rr].*" languagerulename="French"/> <!-- Umbruchregeln für Japanisch --> <languagemap languagepattern="[Jj][Aa].*" languagerulename="Japanese"/> <!-- Allgemeine Umbruchregeln --> <languagemap languagepattern=".*" languagerulename="Default"/> </maprules> </body></srx>Satztrenner für asiatische Sprachen ändern
Abschnitt betitelt „Satztrenner für asiatische Sprachen ändern“Normalerweise wird der Punkt als Satztrenner verwendet. Bei einigen asiatischen Sprachen ist das jedoch nicht der Fall. Im Chinesischen ist beispielsweise der ideografische Punkt (。) der typische Satztrenner. In solchen Fällen kannst du den folgenden Regelsatz verwenden:
<rule break="yes"> <beforebreak>[\x3002]+</beforebreak> <afterbreak></afterbreak></rule>Im folgenden einfachen Satz zeigen wir einen Fall, in dem es notwendig ist, einen Textabschnitt beim Segmentieren in zwei (oder mehr) Zeichenfolgen aufzuteilen.
Text mit Standard-Segmentierungsregeln:
Dies ist der erste Teil des Beispielsatzes und dies ist der zweite Teil.
Text mit neuen Segmentierungsregeln:
Dies ist der erste Teil des Beispielsatzes
und dies ist der zweite Teil.
Für diesen speziellen Fall teilt der folgende Regelsatz den ursprünglichen Satz in zwei Teile:
<rule break="yes"> <beforebreak>sentence</beforebreak> <afterbreak>\u0020</afterbreak></rule>Segmentierungsregeln mit SRX-Editoren erstellen
Abschnitt betitelt „Segmentierungsregeln mit SRX-Editoren erstellen“Die SRX-Segmentierungsregeln können mithilfe von Tools wie Ratel erstellt und verwaltet werden. Ratel verfügt über eine visuelle Oberfläche, mit der du Segmentierungsregeln von Grund auf erstellen oder vorhandene Regeln bearbeiten kannst.